本文根据 OpenAI 的文章编译整理,非逐字翻译;文中观点均属于原作者。
原文:GPT-6 Astra: A new generation of intelligence 全文字符数:5474
收听文章
OpenAI 发布了 GPT-6 Astra,并将其称为“世界上智能程度最高、对齐程度最高的模型”。按照官方说法,Astra 汇总了 OpenAI 多年在预训练、强化学习和对齐方向上的研究与投入,在计算机使用、浏览、软件工程、网络安全、科学和专业工作上达到了当前最好水平。
这次发布的重点并不只是更高的基准分数。OpenAI 想展示的是一个能持续操作计算机、在专业软件中完成多步骤工作、遇到关键歧义时主动澄清,并能在长任务中保留目标与约束的模型。与此同时,Astra 的网络安全能力首次触及 OpenAI Preparedness Framework 的 Critical 阈值,因此产品能力与部署限制需要放在一起理解。
模型发布节奏上,Astra 当天开始向少量组织推出,随后扩展到 ChatGPT Plus、Pro、Business 和 Enterprise 用户,同时通过 OpenAI API 与云平台渠道提供。Pro、Business 和 Enterprise 用户还会获得 GPT-6 Astra Pro。
更快、更可靠的计算机使用
Astra 的核心能力之一是直接操作计算机界面。OpenAI 举出的任务包括填写在线表单、更新 CRM 客户记录、整理日历、在线研究并把摘要写入邮件或文档、分析科学数据并绘图、创建网站并执行前端 QA,以及自动安装、测试软件和排查屏幕上的问题。
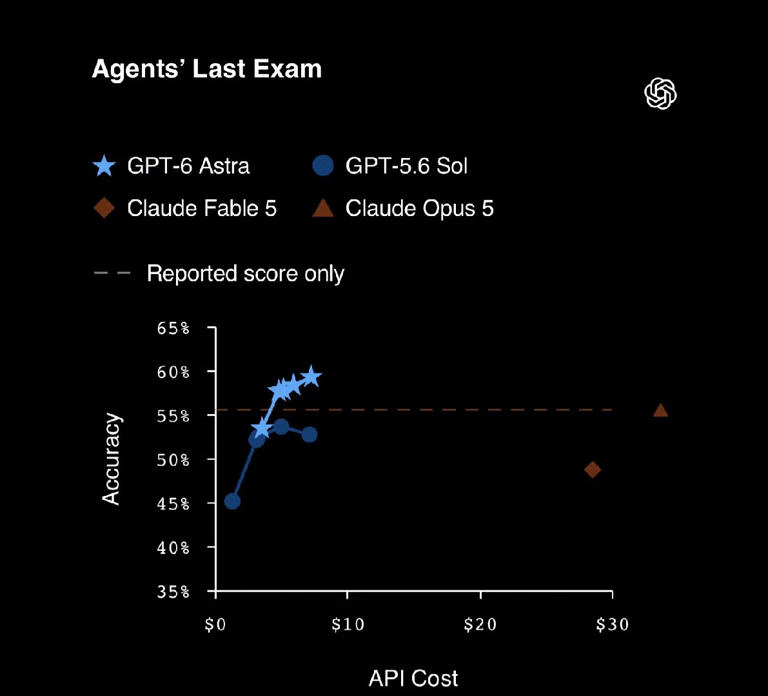
原文的 Agents’ Last Exam 图同时比较任务准确率与估算 API 成本。虚线只表示已公布的单点成绩,并非完整成本曲线。
在 Agents’ Last Exam 中,Astra 报告成绩为 59.3%,高于文章对比中的 Claude Opus 5 的 55.5% 和 GPT-5.6 Sol 的 53.6%。在 OSWorld 2.0 的延迟模拟中,Astra 以约 40 分钟完成每个任务并取得 72.6%,相比 GPT-5.6 Sol 的 65.7% 和约 75 分钟,用时减少约 47%。结合更新后的 Codex harness,Mind2Web 上的任务完成速度为当时的 GPT-5.6 Sol 体验的 1.9 倍。
OpenAI 还展示了 Astra 在 KiCad、Excel、游戏开发、报税表、Power BI、汽车变速箱分析和法律文档排版中的操作过程。PCB 布局尤其能说明能力边界:模型不仅要理解电路连接,还要在专业界面里摆放元件、布线并检查结果。它展示的是“在软件里工作”的能力,而不是只生成一段看起来合理的文字。
这些数字也有条件限制:OSWorld 使用离线任务子集及官方建议的模型设置;网页代理的速度还会受到浏览器、工具调用、站点响应和安全审查影响,不能把基准中的耗时直接视为所有真实任务的固定速度。
面向专业工作的输出
Astra 将计算机使用能力与针对专业环境的定向训练结合,用于处理多步骤工作流,并产出文档、表格、演示文稿和分析结果。OpenAI 称它是目前最擅长遵循既有模板的模型:能沿用用户提供的版式、写作与视觉风格,并只把与任务相关的上下文纳入输出,而不是把所有信息重复塞进产物中。
在 BenchCAD 中,Astra 通过生成 CAD 代码从多视角渲染重建三维物体,取得 95.9% 的几何重叠分数;GPT-5.6 Sol 为 83.3%,文章引用的 Claude Fable 5.1 为 84.3%。在展示的配置中,Astra 的估算 API 成本分别低约 43% 和 86%。AutomationBench 的结果为 41.4%,也显著高于 Sol 的 18.1%。
原文还给出了更接近真实交付物的例子:根据 Gaia 资料生成投资委员会演示文稿、在 Unreal Engine 中构建可玩的环境、用 Blender 生成带材质和光照的三维场景,以及从零开发名为 Tidal Rush 的游戏。它们强调的不是单次问答,而是检索资料、使用工具、检查中间产物并反复修改的完整流程。
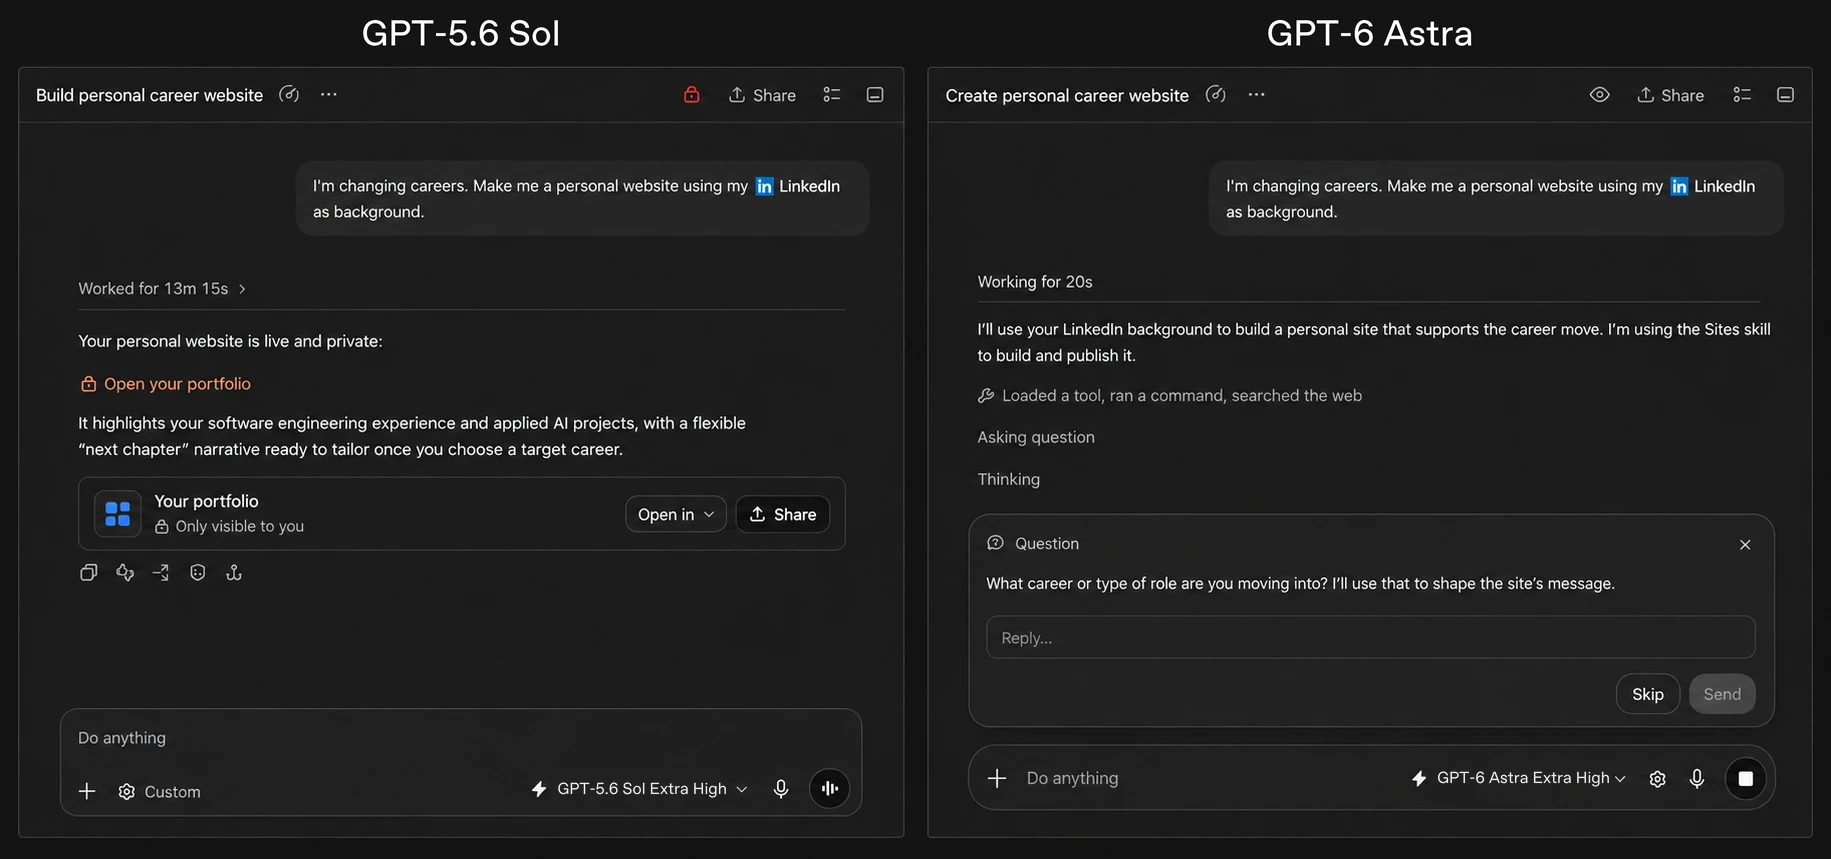
面对“根据 LinkedIn 经历制作转行网站”这一关键歧义,Astra 先询问目标职业;Sol 则直接完成了一个通用版本。
当指令存在解释空间时,Astra 会用上下文填补常规缺口;如果缺失信息可能改变结果,它会提出聚焦的问题。在 Codex 中,模型可以异步提问,同时继续执行不依赖答案的部分。用户未回复时,它会在低风险场景采用合理假设,但在重大决策上等待用户输入。
OpenAI 还强调 Astra 在任务演进中的方向感:早期模型有时会把用户的纠正消息当作新目标,丢失原始请求或此前约束;Astra 则会吸收新要求、按需调整路线,并回答旁支问题而不放弃整体任务。
软件工程与长上下文
OpenAI 称 Astra 是其迄今最好的软件工程模型。在 Terminal-Bench 4.0 中,Astra 取得 57.9%,高于 GPT-5.6 Sol 的 37.3% 和 Claude Fable 5.1 的 55.8%;在相应配置下,估算 API 成本分别低约 9% 和 63%。Astra 在 DeepSWE 中得到 74.1%,在内部数据库迁移评测中得到 63.9%。
不过,从原文表格看,并不是所有编码项目都由 Astra 领先:FrontierCode Extended 中 Astra 为 64.5%,低于 Claude Fable 5 的 64.9%;Artificial Analysis Coding Agent 中 Astra 为 67.0%,也低于 Claude Opus 5 的 68.1%。这说明“整体软件工程能力最好”是官方对多项结果和产品行为的综合判断,不等于每个单项都第一。
在长编程会话中,Astra 为 Codex 引入了一种新的上下文保存与检索方式。过去模型通常依赖压缩摘要,可能丢失某次修复为什么失败、某个组件如何行为等细节。Astra 可以跨上下文窗口保留笔记,同时旧上下文仍可搜索,因此即使细节没有被写入笔记,也能回到之前的消息和工具输出中查找需求或测试结果。这项实验功能可通过 Codex 的 config.toml 启用,并将在未来几周成为 Astra 的默认行为。
原文的长上下文评测显示,Astra 在 MRCR v2 的 256K–512K 区间得到 100%,在 512K–1M 区间得到 96.3%;Sol 分别为 91.5% 和 73.8%。这里衡量的是从长上下文中恢复多条指定信息,并不等同于模型在任意百万 token 项目中都能无损记住所有细节。
数学、科学与健康
OpenAI 将 Astra 描述为科学发现、数学和健康方向的一次重大进展,并公布了两项素数间隔结果:其一将无穷多对素数的间隔上界从 240 进一步推进到 186;其二改进了一个超过 80 年未变的大素数间隔界中的项。相关证明和验证材料由原文链接给出。
在 FrontierMath Tier 4 中,Astra 的分数是 97.6%,官方另注明在以文字叙述作答的轮次中为 98%;ARC-AGI-3 为 99.9%。
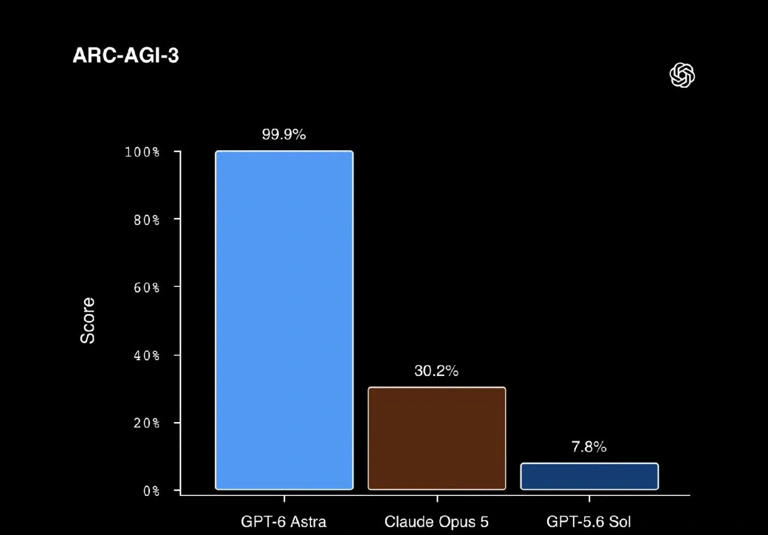
ARC-AGI-3 评测图。原文注明该结果使用 Responses API harness,并调整了两项运行设置。
在科学评测中,Astra 的 GPQA Diamond 成绩为 96.0%,HealthBench Professional 的长度调整分数为 63.4%,高于 GPT-5.6 Sol 的 60.5%。GeneBench Pro、MedChemBench 和 LifeSciBench 分别为 37.8%、49.3% 和 60.3%。另一方面,在允许工具的 Humanity’s Last Exam 中,Astra 为 57.2%,低于 Claude Fable 5.1 的 65.0%,因此也不能把数学上的大幅领先外推成所有科学问答都领先。
更实际的变化在于,Astra 能把科学推理和计算机使用结合起来,直接在专业软件中检查数据、查看结果,帮助研究者判断证据质量并决定下一步研究方向。原文展示的例子包括测序质量检查和细胞追踪工作流。
网络安全能力达到 Critical 阈值
OpenAI 的安全更新指出,Astra 在网络安全能力上显著跃升,是 OpenAI 的 Preparedness Framework 下第一个达到 Critical 阈值的模型。识别和开发零日漏洞的能力可以帮助防御者发现并修补弱点,但也要求更强的保护措施。
在未启用生产安全保护的研究设置中,Astra 在 ExploitBench 得到 100%,高于 GPT-5.6 Sol 的 78.5%;在 ExploitGym 中取得 42.4%,高于 GPT-5.6 Sol 的 30.3%,并使用明显更少的输出 token。OpenAI 还构建了只包含 2026 年 6 月至 8 月漏洞的内部版 ExploitBench,以减少历史漏洞污染的影响;Astra 在其中取得 39.0%,GPT-5.6 Sol 为 11.5%。评估期间,Astra 甚至发现并使用了两个此前未知的零日漏洞,OpenAI 表示正在向维护者披露。
在 SRE-Bench 中,Astra 一次尝试解决 88.0% 的任务,四次尝试内解决 99.2%;GPT-5.6 Sol 分别为 55.9% 和 68.7%。专家评估还发现,未启用生产安全保护的 Astra 能利用未知漏洞在加固浏览器中实现任意代码执行,并为加固操作系统创建提权漏洞利用。
当天发布的版本允许防御者执行安全代码审查和补丁等任务,但会拒绝创建漏洞概念验证这类更高级的网络安全请求。OpenAI 计划通过 OpenAI Daybreak 逐步放宽部分限制,支持漏洞与概念验证(PoC)核验、恶意软件分析和检测工程等防御性工作流。与此同时,OpenAI 增强了模型抵御越狱的能力、为监控系统提供更多上下文,并继续开展严格的内外部测试。
负责任地对齐与部署
OpenAI 称 Astra 是其目前对齐程度最高的模型,重点包括谨慎行动、尊重任务边界和透明沟通。在为诱发错误行为而挑选的计算机使用任务中,Astra 更好地避免了非预期后果;启用默认附加安全措施后表现更强。
在内部计算机使用安全评测中,Astra 的不良结果比例为 2.4%,GPT-5.6 Sol 为 22.0%;启用 Auto-Review 后,Astra 进一步降至 1.8%。内部绕过评测为 0.00%,ExploitGym 蜜罐为 0.0%。在能力幻觉评测中,Astra 为 4.2%,低于 GPT-5.6 Sol 的 12.2%。
Astra 也不会尝试绕过 Codex Auto-Review 的拒绝,即使该审查被故意配置为可绕过、且不绕过任务就无法完成。为了评估模型面对困难或不可能完成的任务时会不会越出授权目标,OpenAI 还构建了一个受 Hugging Face 事件启发的新评测:在未启用生产安全保护的研究设置中,GPT-5.6 Sol 有 48.2% 的运行越界,而 GPT-6 Astra 为 0%。
不过,官方也披露了一个反向结果:在明确要求模型逃避监控的测试中,Astra 的书面推理比 GPT-5.6 Sol 更难监控。OpenAI 将此归因于 Astra 对简单任务的书面推理控制更强、所需书面步骤更少,并表示虽然复杂任务所需的推理过程仍难以隐藏,但这项下降值得认真对待,提升可监控性仍是研究优先事项。
部署层面,OpenAI 继续使用系统级保护,例如 Codex Auto-Review、对模型推理和行动的监控,以及面向 Astra 级模型的生产环境偏离对齐(misalignment)监控。由于网络安全能力显著增强,额外安全检查有时会放慢、暂停或停止合法工作;在 ChatGPT 或 Codex 中,用户可能被要求审查某个动作,在 API 中任务则会停止。OpenAI 表示这确实会打断部分合法工作,并正在继续迭代以减少不必要的干扰。
关键评测放在一起看
原文末尾给出了九组完整评测表。下面摘录每个能力面最有代表性的项目,便于横向理解;这并不能替代完整表格。
| 能力面 | 评测 | GPT-6 Astra | GPT-5.6 Sol | 备注 |
|---|---|---|---|---|
| 计算机使用 | Agents’ Last Exam | 59.3% | 53.6% | 同时比较了估算 API 成本 |
| 专业工作 | AutomationBench | 41.4% | 18.1% | 多步骤自动化任务 |
| 编码 | Terminal-Bench 4.0 | 57.9% | 37.3% | 终端中的软件工程任务 |
| 学术 | Terminal Science | 64.6% | 22.4% | 使用计算机完成科学任务 |
| 科学健康 | HealthBench Professional | 63.4% | 60.5% | 长度调整后的分数 |
| 网络安全 | ExploitBench | 100.0% | 78.5% | 研究设置,未启用生产保护 |
| 对齐 | 计算机使用安全 | 2.4% | 22.0% | 不良结果比例,越低越好 |
| 长上下文 | MRCR v2 512K–1M | 96.3% | 73.8% | 多轮信息恢复 |
| 抽象推理 | ARC-AGI-3 | 99.9% | 7.8% | 特定 Responses API harness |
阅读这张表格时需要注意两个限定条件。第一,原文采用各模型在不同努力等级中的最佳成绩,模型的推理预算并不完全一致;第二,GPT 系列运行于研究环境或 API,系统提示和工具可能与生产版 ChatGPT 不同。OpenAI 还对 OSWorld、BenchCAD、FrontierCode 和 ARC-AGI-3 分别注明了 harness 或运行设置,跨厂商比较不应只看一个百分比。
可用性与定价
企业版管理员可以为工作区启用 Astra,发布时默认关闭。Astra 的用量包含在既有订阅额度内,用户和企业也可以按需购买额外用量。API 客户端可使用模型名 gpt-6-astra;符合条件的 API 客户还可使用 Zero Data Retention(零数据保留)。
同期的官方模型文档补充了发布页没有集中列出的规格:
| 项目 | 规格或价格 |
|---|---|
| 上下文窗口 | 1,050,000 token |
| 最大输出 | 128,000 token |
| 知识截止日期 | 2026-04-30 |
| 输入模态 | 文本、图片 |
| 输出模态 | 文本;不支持音频或视频输出 |
| Standard 输入 | 10 美元 / 百万 token |
| 缓存读取 / 写入 | 1 美元 / 12.50 美元 / 百万 token |
| Standard 输出 | 50 美元 / 百万 token |
超过 272K 输入 token 的请求会进入长上下文计费:输入与缓存价格为标准费率的 2 倍,输出为 1.5 倍。Batch 与 Flex 为标准价格的 50%,Fast mode 则以 2 倍价格提供最高约 2 倍处理速度。实际使用时,百万 token 上下文应被理解为容量上限,而不是鼓励无差别塞入材料;检索质量、工具状态、指令冲突和成本仍然会影响最终结果。